

Inkling 2 Mini: IA potente en tu laptop, qué cambia para tu negocio
El 20 de noviembre de 2026, Thinking Machines Lab, el laboratorio fundado por Mira Murati, presentó Inkling 2 Mini: un modelo de pesos abiertos, con licencia Apache 2.0, que cabe en una laptop. La empresa lo presenta como un modelo rápido y capaz, pensado para computadoras personales.
La noticia cambia dónde ocurre la IA. Antes, usar un modelo capaz solía implicar enviar datos a un servidor y pagar por tokens. Inkling 2 Mini corre en local, sin internet, en una Mac con 32 GB o más de RAM. Para una agencia o un equipo que automatiza con n8n, eso reabre la conversación sobre privacidad, costo y control.
Qué es Inkling 2 Mini
Es multimodal —texto e imágenes de entrada, texto de salida— y tiene contexto de hasta 1M tokens. Usa Mixture-of-Experts: 26.4B parámetros totales y 3.4B activos; por el bucle, 5.4B efectivos por token. Con una huella de unos 20 GB, entra en laptops de consumo y computadoras de escritorio para IA.
Los pesos completos están en Hugging Face con licencia Apache 2.0, que permite uso comercial. La ficha lo orienta a apps con IA, agentes y uso de herramientas, asistentes de código, chatbots y RAG. En idiomas: inglés y soporte multilingüe general.
Inkling 2 Mini en resumen
| Concepto | Detalle |
|---|---|
| Qué es | Modelo abierto y multimodal; texto e imágenes de entrada, texto de salida. |
| Quién lo lanzó | Thinking Machines Lab, el laboratorio fundado por Mira Murati. |
| Fecha | 20 de noviembre de 2026. |
| Tamaño | 26.4B totales, 3.4B activos (5.4B efectivos por token). |
| Memoria | Unos 20 GB. |
| Dónde corre | Mac con 32 GB o más (MacBook, Mac mini, Studio) vía Ollama; DGX Spark; GPU con 32 GB+ de VRAM. |
| Contexto | Hasta 1M tokens. |
| Entradas | Texto e imágenes; salida en texto. |
| Licencia | Apache 2.0 (uso comercial permitido). |
| Idiomas | Inglés y soporte multilingüe general. |
| Punto fuerte | Agentes, herramientas, código y documentos; eficiencia por joule. |
| Limitaciones | Chat de muchas vueltas e instrucciones con muchas restricciones; no suma conocimiento factual. |
Qué lo hace diferente: el truco del bucle
Tres pasadas por token, en lenguaje simple
Es un «looped transformer»: las capas intermedias se ejecutan tres veces por cada token. En vez de agrandar la red, reutiliza su estructura para pensar más antes de responder. Según la empresa, así llega a la respuesta correcta con menos tokens, sobre todo en programación con agentes.
Resultados: qué dicen los números
Thinking Machines Lab reporta que lidera a todos los modelos abiertos de menos de 100B parámetros totales en DeepSWE v1.1 (48.2%) y Vals Index v2.2 (46.5%), y que corre más rápido que modelos de rendimiento similar. En su tabla: MCP Atlas 82.7% (el mejor de la tabla), BrowseComp 79.0% con compactación, SWE-bench Verified 79.2%, AutomationBench-AA 41.8% (segundo, tras Qwen3.8-27B con 48.2%) y OmniDocBench v1.6 92.8% en lectura de documentos.
Son cifras de la empresa, contra modelos abiertos de menos de 100B parámetros, no contra los modelos de frontera de GPT, Claude o Gemini. El modelo compensa su menor conocimiento con búsqueda y herramientas: lidera en BrowseComp, DeepSearchQA y MCP Atlas entre los abiertos de su tamaño.
Stanford (Hazy Research y Scaling Intelligence Lab) midió su «inteligencia por joule»: 0.703 en DGX Spark, frente a 0.430 de Qwen3.6-35B-A3B y 0.036 de Qwen3.5-27B.
Demos: Thinkyville y el avión sin wifi
Thinkyville es la demo que mejor lo explica: un pueblito pixelado con 20 habitantes que son agentes de Inkling 2 Mini, en una sola MacBook Pro (M5 Pro, 48 GB), en modo avión y sin internet.
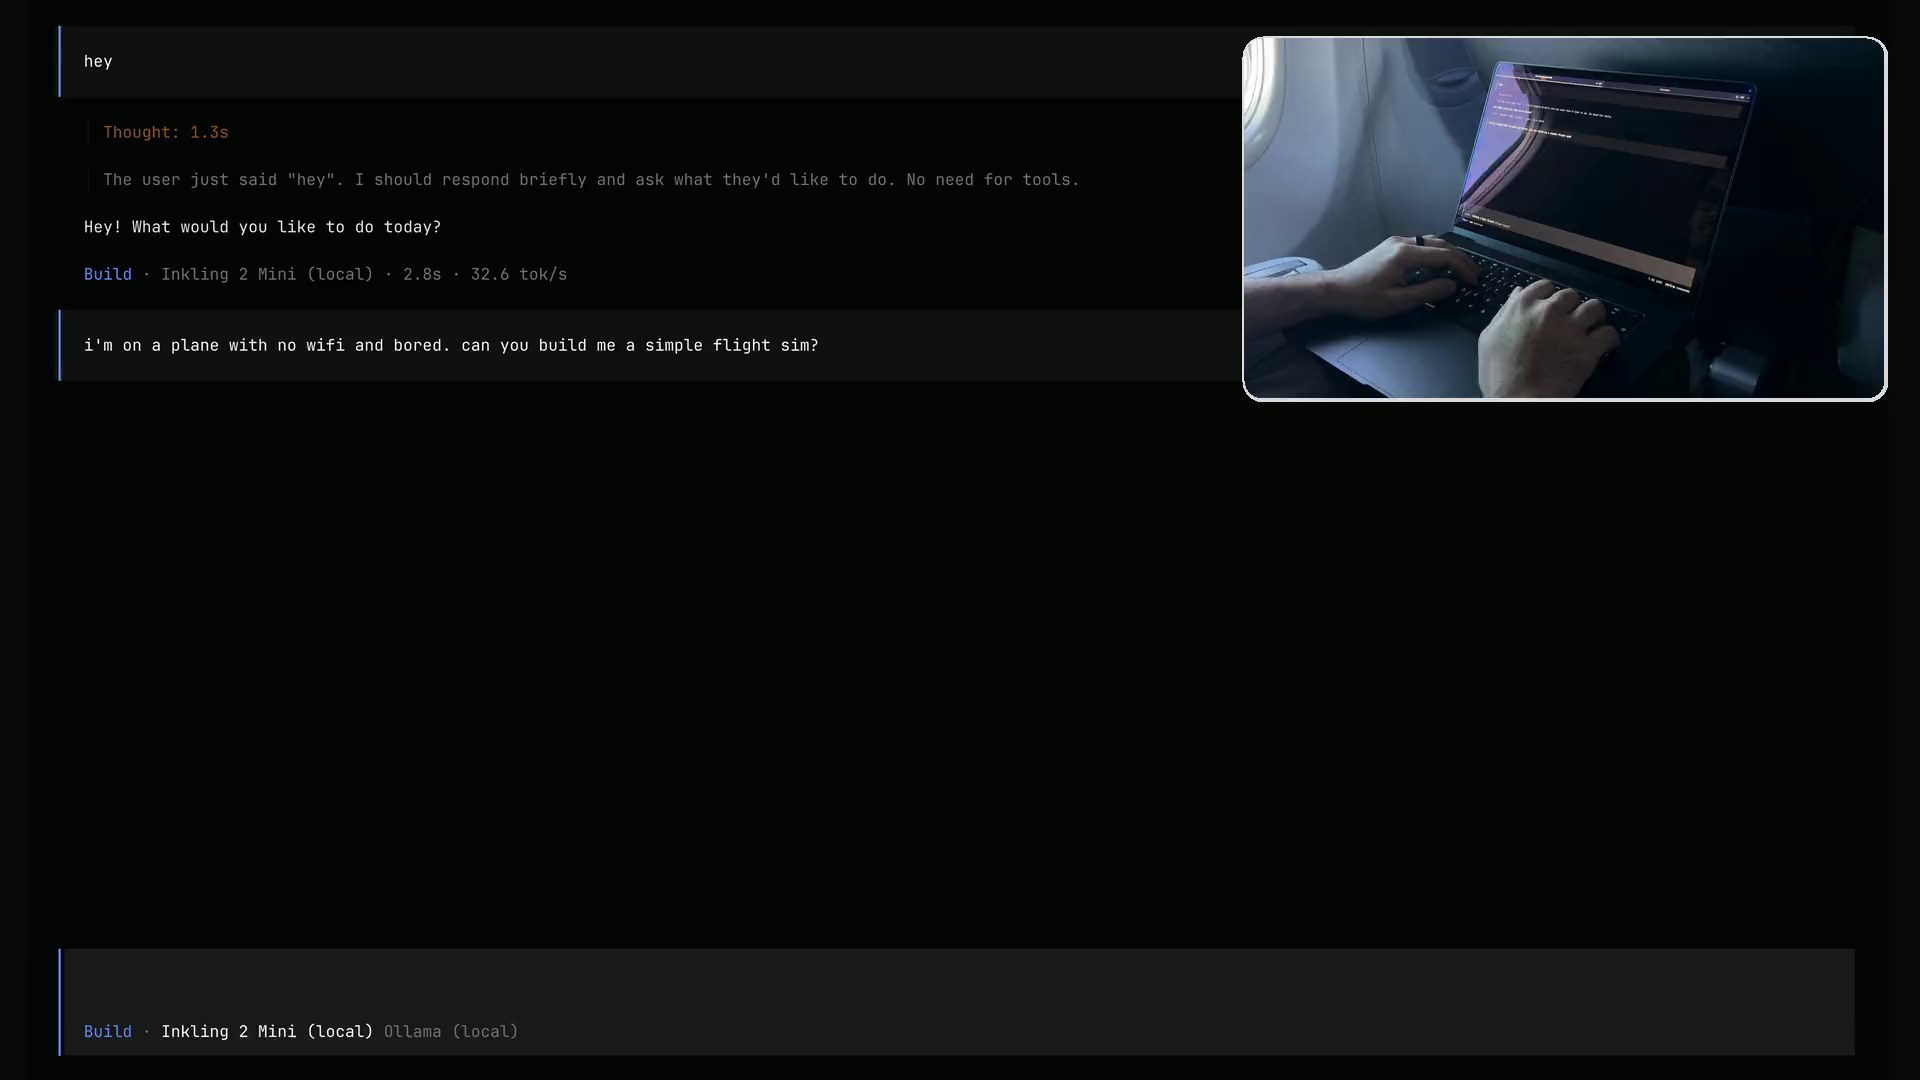
La otra: en un avión sin wifi, el modelo vía Ollama programa un simulador de vuelo. La IA deja de depender de la conexión y se vuelve una herramienta instalada.
Sus limitaciones, sin maquillaje
La empresa es clara sobre lo que no es: no brilla en conversaciones de muchas vueltas ni en encargos con muchas restricciones. Obtiene 50.0% en MultiChallenge y 33.4% en ComplexConstraints v1.1, por detrás de Qwen3.8-27B. En razonamiento intensivo (CritPt v2, HLE-Diamond) queda atrás de modelos más grandes.
El bucle tampoco le añade conocimiento factual: en factualidad se queda al nivel de modelos de su tamaño. Si dependes de datos actuales o catálogos internos, no necesitas un modelo más grande, sino contexto, documentos y búsqueda.
Qué significa para tu negocio
Privacidad: tus datos se quedan en tu equipo
En local, la información no sale de la máquina. Clientes, contratos, facturas, tickets y notas internas se procesan ahí. Para un despacho contable, una agencia con acuerdos de confidencialidad o un equipo de salud, eso simplifica la conversación con legal y reduce la exposición.
Costo: dejas de pagar por token
Una vez que tienes el hardware, no hay pago por token. El costo se vuelve inversión fija y energía, no una línea que crece con cada llamada. No es gratis: hay que comprar o asignar el equipo, mantenerlo y aceptar su capacidad. Pero en alto volumen, la cuenta cambia.
Offline: la IA funciona sin internet
Sin conexión, el modelo sigue respondiendo: sirve en campo, en viajes, en sucursales con red inestable y para prototipar sin cuenta ni llave de API.
¿Local o por API? La regla práctica de Azul School
Regla práctica: tareas repetitivas, privadas y de alto volumen, a local; razonamiento difícil, chat largo con muchas instrucciones y preguntas de conocimiento amplio, a la API o a local con búsqueda y RAG. La tabla siguiente es nuestra recomendación.
¿Modelo local o modelo por API?
| Situación | Mejor opción | Por qué |
|---|---|---|
| Clasificar o resumir correos, tickets o documentos con datos sensibles | Local | El contenido no sale de tu equipo y desaparece el costo por llamada. |
| Alto volumen repetitivo (miles de llamadas al día) | Local | Sin pago por token; el gasto se concentra en el hardware. |
| Agente que usa herramientas y búsqueda | Local puede funcionar; prueba primero | Fuerte en MCP Atlas y BrowseComp; mide tu caso antes de migrar. |
| Chat largo con clientes con muchas reglas | API de frontera | El modelo pequeño flojea con muchas restricciones. |
| Preguntas que dependen de mucho conocimiento general | API o local + RAG | El bucle no agrega conocimiento factual; dale fuentes. |
| Sin hardware de 32 GB | API o proveedores de terceros | También está disponible vía API con proveedores de inferencia. |
Muchas empresas terminan en un esquema mixto. Para la parte local, el taller Integrando Inteligencia Artificial en n8n te ayuda a conectar modelos de IA a tus flujos; el taller de Implementación de OpenRouter en n8n, a alternar proveedores sin rehacer el flujo.
Para que el modelo trabaje con tus documentos, el taller de Sistema RAG con Google Drive y PostgreSQL cubre esa pieza. Si buscas otra vía por API para bajar el costo por volumen, revisa Meta Muse Ember, el modelo barato para el volumen de agentes. Y para decidir entre modelos, usa la guía de elección de modelos de lenguaje para uso profesional.
Cómo probarlo con n8n (paso a paso)
n8n tiene un nodo Ollama Chat Model que se conecta a un servidor de Ollama; así un AI Agent puede usar un modelo local. También puedes usar proveedores vía OpenRouter. Los pasos:
- Revisa que tu Mac tenga 32 GB o más de RAM, o que tu GPU tenga 32 GB o más de VRAM.
- Instala Ollama y descarga el modelo desde su biblioteca o la versión GGUF.
- Pruébalo en el chat con un caso real de tu negocio, con datos de prueba.
- En n8n, usa el nodo Ollama Chat Model dentro de un AI Agent apuntando a tu servidor Ollama.
- Compara calidad y tiempo contra tu modelo de API actual antes de cambiar.
Inkling 2 Mini está pensado para que cualquiera pueda correr un modelo capaz en su propia laptop, con la misma precisión con la que fue entrenado.
Thinking Machines Lab (20 nov 2026)
Qué hacer mañana en tu negocio
- Identifica qué procesos usan datos que no quieres mandar a la nube.
- Calcula cuánto gastas hoy en tokens al mes.
- Elige un proceso de alto volumen para un piloto local.
- Combina local + RAG con tus documentos.
- Deja la API de frontera solo para lo difícil.
Para llevar esto a la práctica, estos talleres te acompañan:
Conclusión
Inkling 2 Mini no reemplaza a los modelos de frontera ni lo pretende. Cambia la opción: un modelo abierto competitivo entre los de su tamaño cabe en una laptop y trabaja sin internet. Eso habilita privacidad real, costo predecible y operación offline. La decisión inteligente no es elegir un bando, sino repartir el trabajo: local para lo repetitivo y privado, API para lo difícil, RAG para lo que exige conocimiento.
Respuestas